¿Cómo puede una célula convertir una secuencia de ADN en una proteína funcional? La respuesta está en el código genético, un sistema de correspondencias que conecta los nucleótidos del material genético con los aminoácidos. Entenderlo permite interpretar mutaciones, explicar cómo se fabrican las proteínas y comprender por qué un pequeño cambio en el ADN puede no tener ningún efecto o alterar una función celular importante.
Las claves para entender cómo se traduce la información genética
- 64 codones forman el sistema de lectura, aunque solo 61 codifican aminoácidos.
- El codón AUG suele marcar el inicio y codifica metionina.
- UAA, UAG y UGA indican que la síntesis de la proteína debe terminar.
- La información pasa del ADN al ARN mensajero y de este a la proteína.
- El sistema es degenerado, porque varios codones pueden representar el mismo aminoácido.
- Las mitocondrias y algunos organismos utilizan variantes del código estándar.
Qué es el código genético y por qué resulta esencial
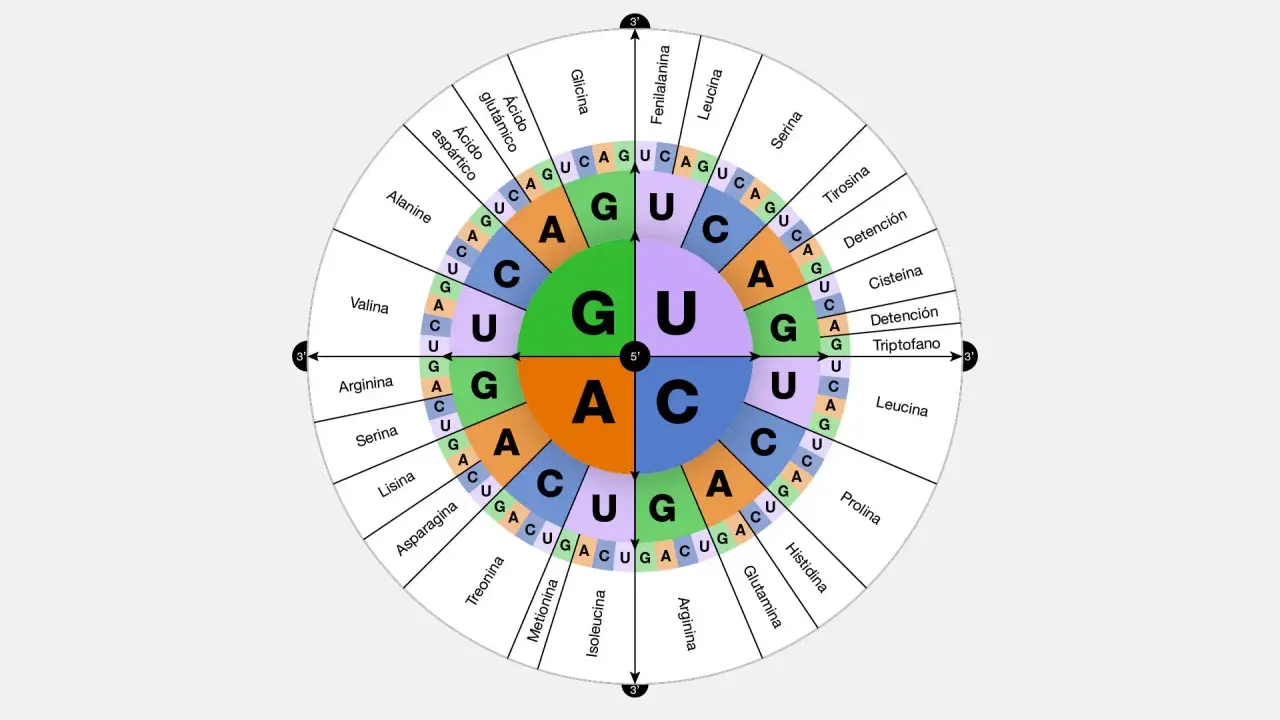
El código genético es el conjunto de reglas que permite traducir una secuencia de nucleótidos en una secuencia de aminoácidos. Dicho de forma sencilla, funciona como un diccionario molecular que indica qué pieza debe añadirse cada vez que el ribosoma lee una parte del ARN mensajero.
La unidad básica de lectura es el codón, una agrupación de tres nucleótidos. Como el ARN utiliza cuatro bases, adenina, uracilo, citosina y guanina, existen 64 combinaciones posibles. De ellas, 61 especifican aminoácidos y 3 actúan como señales de parada.
Conviene no confundir este sistema con el genoma, el conjunto completo del ADN de un organismo, ni con el genotipo, que describe sus variantes genéticas. El código es la regla de traducción; el genoma es el contenido que se interpreta. El NHGRI también distingue estos conceptos porque suelen mezclarse en explicaciones divulgativas.
Cómo se transforma el ADN en una proteína
La fabricación de una proteína ocurre en dos grandes etapas. Primero, la información de un gen se copia desde el ADN a una molécula de ARN mensajero. Después, el ribosoma lee ese ARN y ensambla una cadena de aminoácidos siguiendo el orden de sus codones.
Transcripción del ADN
Durante la transcripción, una enzima produce una copia de ARN a partir de una de las cadenas del ADN. En esa copia, el uracilo sustituye a la timina. El resultado no es una proteína todavía, sino una especie de mensaje transportable que contiene las instrucciones necesarias para fabricarla.
Lee también: Metabolismo ATP - Claves de la energía celular y genética
Traducción en el ribosoma
En la traducción, el ribosoma avanza por el ARN mensajero en grupos de tres letras. Cada codón se aparea con un ARN de transferencia, cuya función consiste en llevar el aminoácido correspondiente. La cadena crece paso a paso hasta que aparece una señal de terminación.
Un ejemplo sencillo sería la secuencia de ARN mensajero AUG-GCU-UUU-UAA. El ribosoma la interpreta como metionina, alanina, fenilalanina y una señal de parada. El último triplete no añade un aminoácido, sino que ordena liberar la proteína recién formada.
El NCI explica este proceso como una lectura coordinada entre el ARN mensajero, el ribosoma y los ARN de transferencia. En la práctica, lo importante es entender que no se traducen letras aisladas, sino codones consecutivos dentro de un marco de lectura.
Las propiedades que hacen que el sistema funcione
El código genético tiene varias características que explican su estabilidad y, al mismo tiempo, su capacidad para tolerar ciertos cambios.
| Propiedad | Qué significa | Por qué importa |
|---|---|---|
| Triplete | Cada codón contiene tres nucleótidos. | Permite obtener 64 combinaciones a partir de cuatro bases. |
| Degeneración | Varios codones pueden codificar el mismo aminoácido. | Algunas mutaciones no cambian la proteína. |
| No ambigüedad | Cada codón concreto tiene un significado determinado en un código dado. | La lectura no depende de una interpretación subjetiva. |
| Casi universalidad | La correspondencia es muy parecida en la mayoría de los seres vivos. | Hace posible comparar genes entre especies y utilizar organismos modelo. |
| Lectura no solapada | Un nucleótido pertenece normalmente a un solo codón dentro del marco de lectura. | Un cambio puntual suele afectar a una posición concreta, aunque existen excepciones. |
La degeneración merece especial atención. Por ejemplo, distintos codones pueden producir leucina, serina o arginina. Los cambios en la tercera base suelen ser más tolerables, aunque no siempre son irrelevantes porque pueden influir en la velocidad de traducción, el plegamiento de la proteína o el procesamiento del ARN.
Codones de inicio, parada y marco de lectura
La traducción necesita un punto de comienzo. En el código estándar, AUG codifica metionina y suele funcionar como codón de inicio. Sin embargo, que exista un AUG no basta por sí solo. El ribosoma también depende del contexto de la secuencia y de señales celulares que ayudan a identificar el lugar correcto.
Las señales de parada son UAA, UAG y UGA. No corresponden a aminoácidos, sino que reclutan factores de terminación y provocan la liberación de la cadena proteica. Si una mutación convierte prematuramente un codón normal en una de estas señales, puede aparecer una proteína demasiado corta.
El marco de lectura determina cómo se agrupan los nucleótidos. En una secuencia como AUG-CCA-GAA, cambiar la posición inicial altera todos los tripletes posteriores. Por eso una inserción o una deleción de una sola base puede producir un desplazamiento del marco de lectura y modificar de forma drástica la proteína resultante.
Este es uno de los errores que más confunde al interpretar secuencias. No basta con contar letras ni con buscar un AUG al azar. Hay que saber qué cadena se está leyendo, en qué dirección, desde qué punto comienza el marco y si el ARN ha sido procesado correctamente.
Qué ocurre cuando cambia una base
Una variación en el ADN no tiene siempre el mismo efecto. La consecuencia depende del codón afectado, de la posición del cambio, del tipo de tejido y de la función de la proteína. En medicina genética, interpretar el cambio exige bastante más que consultar una tabla de codones.
- Mutación sinónima. El nuevo codón especifica el mismo aminoácido. No siempre es completamente neutra, porque puede afectar al procesamiento o a la velocidad de síntesis.
- Mutación missense. Cambia un aminoácido por otro. El resultado puede ser inocuo, alterar parcialmente la función o causar una enfermedad.
- Mutación nonsense. Convierte un codón que codifica un aminoácido en una señal de parada prematura.
- Inserción o deleción con desplazamiento. Modifica la agrupación de los tripletes y suele alterar toda la secuencia posterior.
- Cambio en el empalme. Puede hacer que el ARN mensajero pierda o incorpore fragmentos que no deberían aparecer en la proteína final.
En mi experiencia al explicar estos resultados, el mayor malentendido consiste en asumir que una mutación equivale automáticamente a una enfermedad. La interpretación correcta necesita información adicional, como la conservación evolutiva del residuo, los datos funcionales, la frecuencia de la variante y el patrón de herencia.
Por qué no todos los organismos usan exactamente la misma versión
Se habla de código estándar porque es la versión más extendida, no porque sea absolutamente idéntica en todos los seres vivos. Algunas mitocondrias utilizan correspondencias diferentes para determinados codones. En ciertos organismos también existen cambios asociados a mecanismos especiales de traducción o modificación del ARN.
Esta excepción tiene consecuencias prácticas. Al analizar una secuencia mitocondrial, aplicar automáticamente la tabla nuclear puede generar una proteína mal traducida. Los programas bioinformáticos suelen pedir una tabla de traducción específica, especialmente cuando se trabaja con genomas de orgánulos, bacterias o especies poco habituales.
También existen aminoácidos incorporados mediante señales especiales. La selenocisteína, por ejemplo, puede insertarse en determinadas condiciones gracias a elementos adicionales de la secuencia y a maquinaria celular específica. No conviene tratar estos casos como simples excepciones de una tabla, porque requieren señales reguladoras que van más allá del codón aislado.
Qué aporta entenderlo en genética y medicina personalizada
Conocer estas reglas ayuda a leer resultados de secuenciación, pero no sustituye el análisis clínico. Una variante puede cambiar un aminoácido y no alterar la función, mientras que otra aparentemente pequeña puede afectar al plegamiento, al transporte celular o a la cantidad de proteína disponible.
En medicina personalizada, el código genético sirve como primer nivel de interpretación. Después hay que integrar el tipo de variante, el gen implicado, el tejido donde se expresa, los antecedentes familiares y la evidencia experimental. Por eso un informe genético responsable no debería presentar una conclusión tajante basándose únicamente en la sustitución de una letra.
Para analizar una secuencia de forma ordenada, yo seguiría este recorrido:
- Confirmar si se está trabajando con ADN codificante, ARN mensajero o la cadena molde.
- Comprobar la dirección de lectura, normalmente de 5’ a 3’ en el ARN.
- Identificar el marco de lectura y el codón de inicio.
- Traducir la secuencia con la tabla adecuada para el organismo.
- Comparar la secuencia normal y la variante.
- Interpretar el posible efecto junto con datos biológicos y clínicos.
La idea esencial es sencilla, aunque sus consecuencias sean profundas. El código genético convierte una secuencia de nucleótidos en instrucciones para construir proteínas, pero el significado biológico de cada cambio depende del contexto. Entender esa diferencia permite leer la genética con más precisión y evitar conclusiones apresuradas.